菲律宾呼叫中心上AI客服:语音与知识库服务器怎么配才不踩坑?
先看清坑:AI客服不是买张GPU卡就完事
马尼拉外包呼叫中心的典型场景是:几十到几百个坐席,英语带口音、夹杂他加禄语,业务知识散落在FAQ文档、历史工单和坐席话术里。想上AI客服,真正容易翻车的地方往往不在模型本身,而在三件事上。
坑一:把语音链路和知识库塞进同一台机器。语音识别(ASR)吃的是实时算力和低延迟,RAG知识库吃的是内存、向量检索和并发,两者抢资源时,通话会卡顿、检索会超时。合理做法是分开部署,至少逻辑隔离。
坑二:忽略菲律宾本地的网络时延。呼叫中心走SIP语音流,对抖动敏感。服务器若放在离马尼拉太远、线路绕行的机房,坐席端会出现“AI答一句、人等三秒”的体验。通常建议选东南亚区域内、对菲律宾有优化线路的节点,把单程时延压到可接受范围。
坑三:知识库直接拿原始文档喂模型。几百页PDF不做清洗切分,检索召回率很低,AI会一本正经地胡说。RAG的效果七成取决于文档预处理和分块策略,而不是模型参数量。
分步上手:从一台机器到一套AI客服
第一步:确定模型规格与显存量级
中小企业私有化部署,常见路线是用Qwen、Llama系列的7B~14B量化版本,配合Ollama或vLLM做推理。7B的4bit量化模型通常占4~6GB显存,14B约8~12GB,加上并发余量,单张16GB~24GB显存的卡就能跑起中小规模问答;若要做实时语音ASR,建议再留一张卡或改用CPU+专用语音服务分流。并发坐席在50以内,这个量级一般够用。
第二步:语音与知识库分开配机
语音网关与ASR服务对CPU和网络IO敏感,配中高主频多核CPU、32GB以上内存即可;RAG知识库侧重点是内存和NVMe盘,向量库(如Milvus、Qdrant)在百万级片段下,64GB内存起步比较稳妥,文档解析和索引重建时磁盘读写压力大,SSD/NVMe能明显缩短重建时间。数据库和向量库不要和推理服务抢同一块盘。
第三步:估算带宽与线路
语音流本身带宽不高,一路通话约几十kbps,但呼叫中心往往还有录音回传、坐席桌面同步、知识库文档上传。按100坐席、每路64kbps粗算,语音约6~7Mbps,再叠加录音与办公流量,通常准备50M~100M独享带宽更从容。线路方面,优先确认机房对菲律宾方向的国际带宽质量和是否有BGP多线,避免晚高峰绕路。
第四步:成本与部署方式取舍
云GPU按小时计费,适合先做POC验证;一旦进入稳定运营,物理机或裸金属的月成本通常更可控。东南亚区域带GPU的物理服务器,市场行情量级多在每月数千元起,具体视卡型与服务商而定;纯CPU的语音网关与知识库节点,月成本可压到千元级。建议先用云资源跑两周真实通话数据,再决定是否转物理机。
第五步:上线前必须做的验收清单
- 用真实带口音的通话录音测ASR字错率,别只用标准普通话样本;
- 知识库做100条高频问题的召回测试,记录Top-3命中率;
- 模拟50并发坐席压测,观察首字延迟和超时率;
- 确认数据存储位置与录音留存策略,满足客户对数据落地的要求;
- 预留人工兜底转接路径,AI答不上来要能一键转坐席。
选购推荐
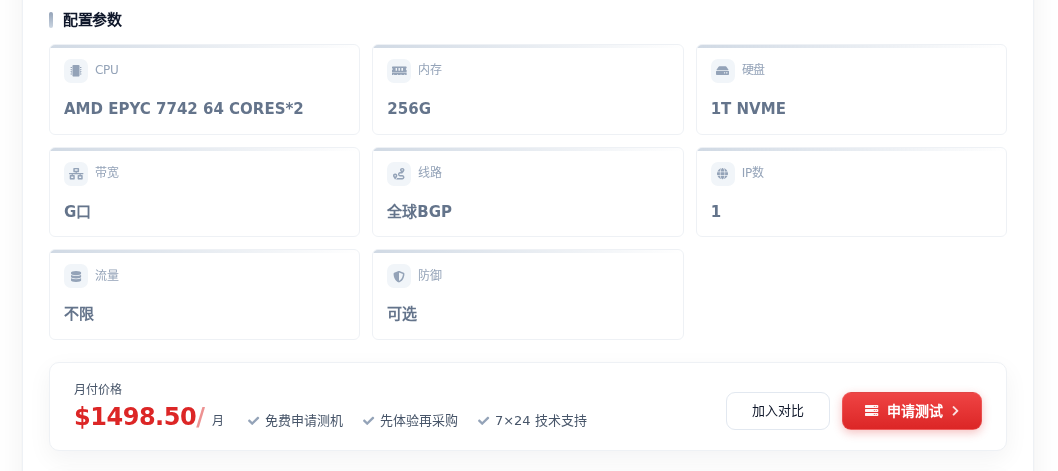
如果知识库与语音服务需要放在东南亚区域、又要兼顾大内存与高带宽,可重点看两类机型。做RAG知识库和向量检索的节点,内存和NVMe是硬指标,马来西亚大带宽服务器 XXIII(AMD EPYC 7742 双路 / 256G / 1T NVME / G口带宽,1498.5 元/月)适合承载向量库、文档解析与索引重建,256G内存能撑住百万级片段的检索并发。若预算更紧、主要跑语音网关和轻量问答,马来西亚大带宽服务器 XIV(E5-2698v4 双路 / 64G / 1T SSD / 50M带宽,628.5 元/月)可作为语音与办公侧节点,50M带宽应付百坐席的语音加录音回传基本够用。GPU推理仍建议单独规划,不要和上述节点混跑。
决策建议
先把语音链路和知识库拆开,用云资源做两周真实通话POC,拿到字错率和召回率数据后再定物理机规格;带宽按坐席数留足余量,线路优先看对菲律宾方向的实测时延。模型选7B~14B量化版本起步,把精力花在文档清洗和兜底流程上,比一味堆显存更划算。