怎样算清菲律宾服务器撑TikTok Shop直播的推流带宽与同步延迟?
做菲律宾本土店矩阵的团队,最容易在同一个晚上踩两个坑:直播间画面开始转圈,同时后台商品改价没同步过去,订单按旧价格成交。多数人第一反应是「服务器不够大」,但推流带宽和商品同步延迟其实是两笔不同的账,混在一起算就会持续加钱、持续出问题。下面按可操作的算法和判断标准拆开讲。
坑一:把推流带宽按「观看人数×码率」算
这是最常见的高估。TikTok Shop 本土店直播的推流链路是:主播端 → 平台 ingest 节点 → 平台分发。服务器在中间承担的是推流中转、多账号并发调度、录播与切片、以及备用推流,而不是把画面分发给每个观众。所以估算对象是上行并发推流数,不是观众数。
- 判断标准:单路 1080p 直播推流一般按 4~6 Mbps 预留,含抖动冗余按 1.5 倍计;一路稳定推流按 8~10 Mbps 规划比较稳。
- 量级参考:10 路并发推流,纯推流带宽 80~100 Mbps 就够;但矩阵团队往往同时跑录播转推、素材上传、后台同步,实际按 1.5~2 倍留余量,即 150~200 Mbps 上行。
- 坑点:很多标称「100M 带宽」的机器是共享或上下行不对称,上行只有十几兆。下单前必须确认上行带宽数值与是否独享,这一条比 CPU 型号重要得多。
- 另一个坑:菲律宾本地机房到 TikTok 接入点的链路质量波动大,带宽够但丢包高,画面照样卡。要问清是否提供 CN2 或优质国际 BGP 回程,以及能否先测试路由。
顺带说一句,部分团队会把推流中转放在马来西亚大带宽机型上做前置,再回源菲律宾,这种混合架构对上行带宽的要求更高,选型时按 G 口级别考虑更省心。
坑二:把商品同步延迟当成「服务器慢」
商品同步延迟的真实来源通常有三层,服务器只是其中一层,盲目升配解决不了。
- 平台 API 限流层:商品改价、库存更新走开放接口,一般有 QPS 限制。矩阵店群几十上百个店铺同时推送,排队就会产生秒级到分钟级延迟。判断标准:看日志里请求是「等待返回」还是「返回慢」,前者是限流,加机器无用。
- 本地任务调度层:同步脚本、ERP 中间件、库存对账任务挤在同一台机器上抢 CPU 和数据库连接。判断标准:同步任务执行时 CPU 是否打满、MySQL 慢查询是否激增。这一层才是服务器该背的锅。
- 网络往返层:服务器到平台接口的 RTT。菲律宾机房到区域接口节点的往返一般在几十毫秒量级,视线路而定。若 RTT 明显偏高或抖动大,同步任务的重试次数会翻倍,延迟被放大。
可落地的做法:把推流服务和商品同步服务分机器或至少分容器隔离;同步任务做队列化与失败重试退避;对价格、库存这类高敏感字段设置「变更即推 + 定时全量校验」双通道。这样即使 API 限流,也能把关键字段的延迟压到可接受范围。
坑三:只看配置不看地区合规与 IP 资源
菲律宾本土店运营对本地网络环境敏感,站群 SEO 从业者转做店群时尤其容易忽略这点。
- IP 纯净度:机房 IP 段是否被平台风控标记,直接影响账号环境稳定性。判断标准:要求服务商说明 IP 段来源,尽量选可提供多 IP、支持更换的机型。
- 合规与备案:菲律宾本地机房对内容与业务类型有各自要求,直播类业务要提前确认是否允许,避免上线后被停。
- 硬件底线:推流中转吃单核性能与网络,商品同步吃内存与磁盘 IO。矩阵规模在 20~50 店时,建议 8 核以上、32G 内存起步、NVMe 盘;再往上按店铺数线性加内存。
- 别忽略计费口径:大带宽机型常按流量或带宽封顶计费,直播是持续上行,流量跑得很快,要算清 50T 这类流量包够撑多久。
选购推荐
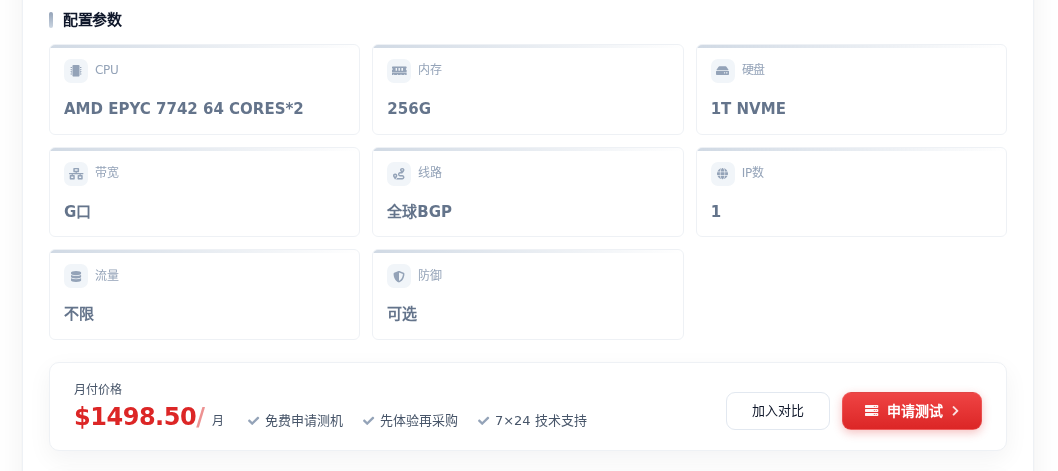
如果推流中转与商品同步都放在东南亚区域,且团队已经在做多店矩阵,带宽上限和内存容量是优先项。秀米云在售的 马来西亚大带宽服务器 XXIII(AMD EPYC 7742 双路 / 256G / 1T NVME / G 口带宽,1498.5 元/月)适合推流路数较多、需要 G 口上行余量的场景,256G 内存也够把同步任务和缓存放在同一台机器上分区隔离。若预算更紧、并发推流在十路上下,马来西亚大带宽服务器 XV(E5-2683v4 双路 / 64G / 1T SSD / G 口带宽,688.5 元/月)是更务实的起步选择,先跑通链路再按实际上行占用扩容。两款都建议下单前确认上行实测与路由质量,这比参数表更决定直播稳不稳。
决策建议:先按并发推流路数×10 Mbps 估上行,再乘 1.5~2 倍留余量,这是带宽底线;商品同步延迟优先查 API 限流与任务调度,别急着升配;选机时把上行带宽是否独享、IP 段纯净度、流量计费口径三项问清,基本能避开大部分坑。